1. บริบท: เหตุใดระบบเดิมจึงล้มเหลว
ระบบเดิมล้มเหลวไม่ใช่แค่เพราะมัน "เก่า" แต่เป็นเพราะ... ข้อจำกัดทางสถาปัตยกรรมโครงสร้าง:
1.1 การเพิ่มขึ้นอย่างมหาศาลของเมตาเดตา
มีตารางประมาณ 400,000 ตารางในสคีมาเดียวโดยไม่มีการจัดการวงจรชีวิต ทำให้ประสิทธิภาพของตัววางแผนการสืบค้นลดลงและเกิดความล่าช้าในการค้นหาข้อมูลในแคตตาล็อก.
1.2 สถาปัตยกรรมแบบเน้นการประมวลผลเป็นชุด
การนำเข้าข้อมูลตามกำหนดการรายเดือน/รายปีโดยไม่มีกลยุทธ์แบบค่อยเป็นค่อยไป ส่งผลให้เกิดช่องว่างความสดใหม่ที่ยาวนานและการแพร่กระจายของความล้มเหลวไปทั่วทั้งระบบ.
1.3 การเชื่อมต่อที่แน่นหนาระหว่างชั้นต่างๆ
การนำเข้า การแปลงข้อมูล และการรายงานมีความเชื่อมโยงกันอย่างแน่นหนา การเปลี่ยนแปลงใดๆ จำเป็นต้องเขียนกระบวนการทำงานใหม่ทั้งหมดโดยไม่มีการนำส่วนใดส่วนหนึ่งกลับมาใช้ใหม่ได้.
1.4 การขาดความสามารถในการสังเกตการณ์
การขาดการติดตามที่มาของปัญหา การตรวจสอบที่จำกัด และการแก้ไขข้อผิดพลาดด้วยตนเองผ่านบันทึก ทำให้การตอบสนองต่อเหตุการณ์เป็นไปอย่างล่าช้าและยุ่งยาก.
2. การออกแบบสถาปัตยกรรม: รายละเอียดโดยละเอียด
2.1 หลักการออกแบบ
ระบบใหม่นี้ถูกสร้างขึ้นโดยยึดหลักการดังต่อไปนี้:
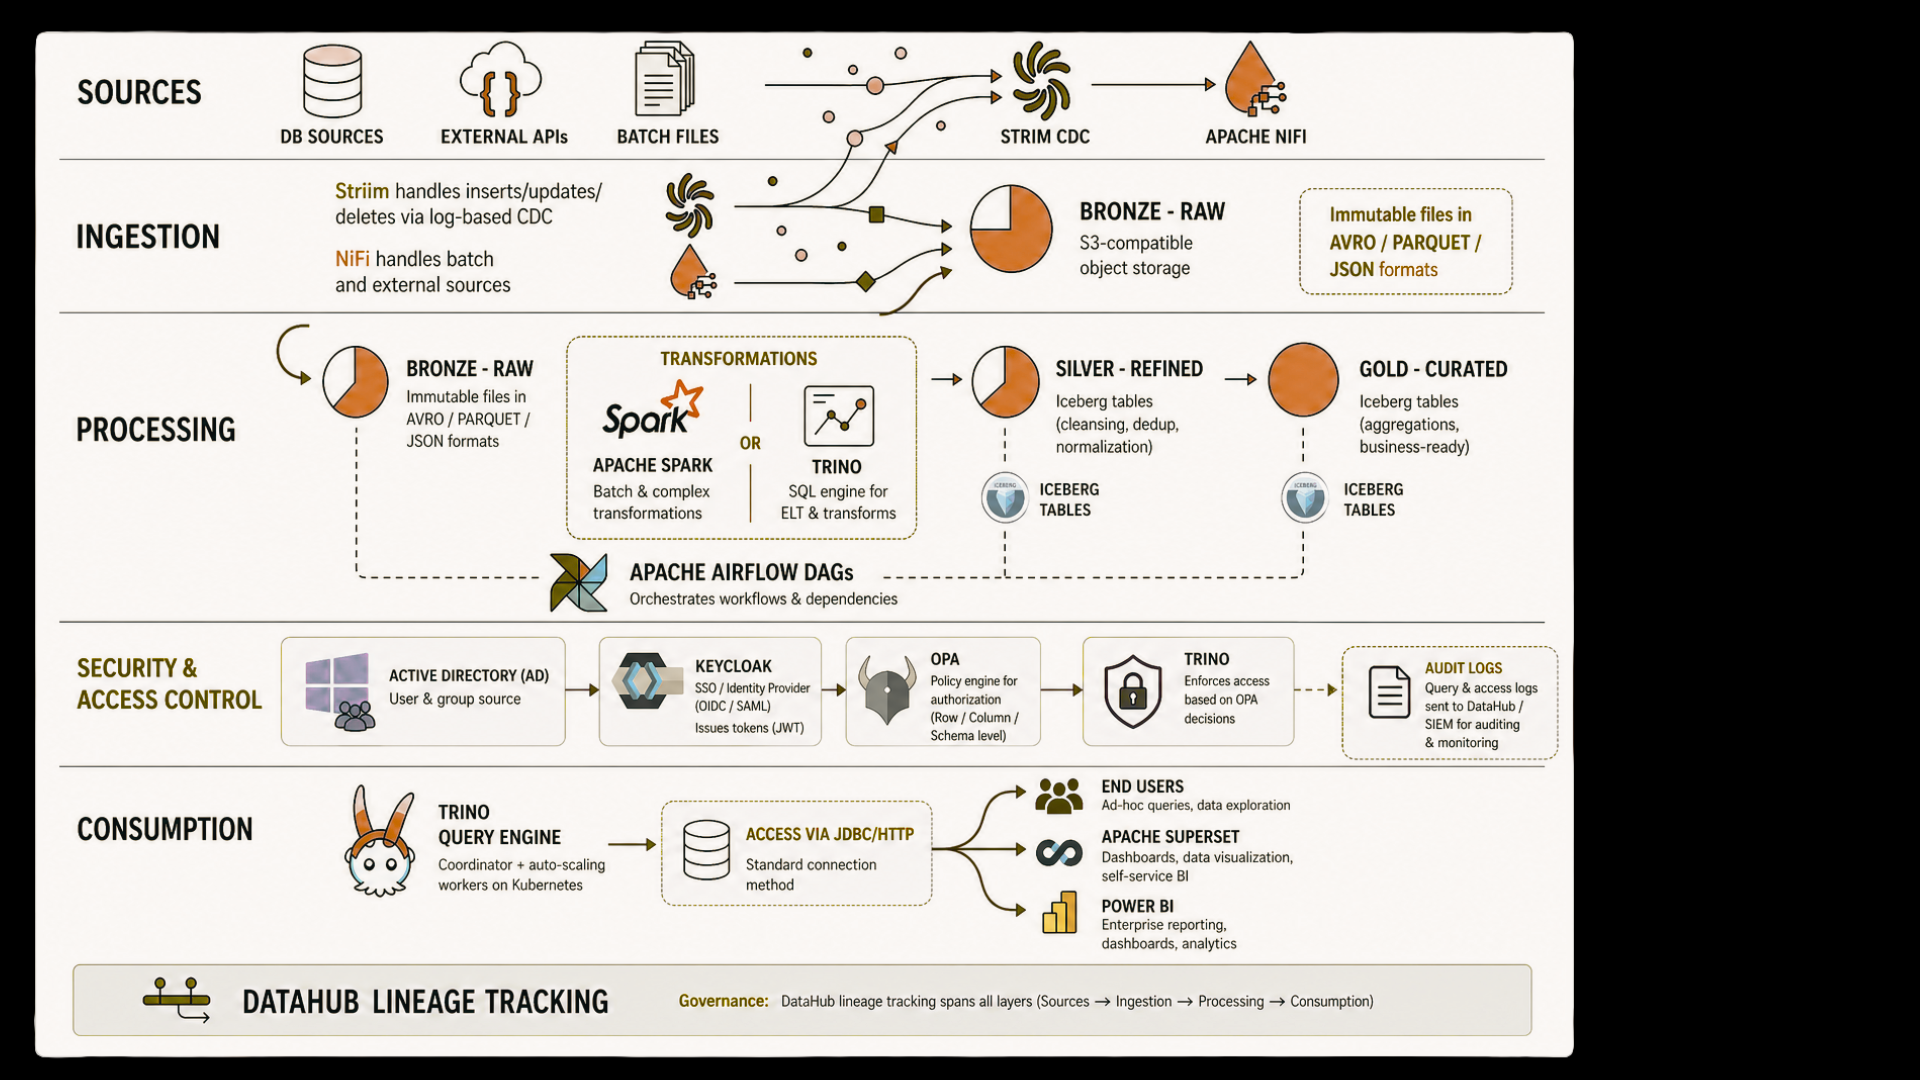
การแยกส่วน: ระบบจัดเก็บข้อมูล (Iceberg) แยกออกจากระบบประมวลผล (Trino) — แต่ละระบบสามารถปรับขนาดได้อย่างอิสระ.
ความไม่เปลี่ยนแปลง: ตารางแบบเพิ่มข้อมูลอย่างเดียวและมีการกำหนดเวอร์ชันจะช่วยป้องกันความเสียหายของข้อมูลและทำให้สามารถย้อนเวลากลับไปในอดีตได้.
สตรีมมิ่งเป็นหลัก: การนำเข้าข้อมูลโดยใช้ CDC แทนที่การประมวลผลแบบแบตช์ ทำให้ได้ข้อมูลที่ทันสมัยเกือบเรียลไทม์.
ภาวะไร้สมรรถภาพทางเพศ: การดำเนินการไปป์ไลน์แบบกำหนดได้แน่นอนช่วยให้มั่นใจได้ว่าการลองใหม่จะปลอดภัยโดยไม่มีข้อมูลซ้ำซ้อน.
ความสามารถในการสังเกตการณ์: มีเมตาเดต้าและการติดตามลำดับวงศ์ตระกูลในตัวตั้งแต่เริ่มต้นผ่านทาง DataHub.
2.2 กลยุทธ์การแบ่งชั้นข้อมูล
เราได้ดำเนินการ แบบจำลองข้อมูลหลายชั้น:
ชั้นที่ 1: ดิบ (บรอนซ์)
- แผนผังที่สอดคล้องกับแหล่งที่มา
- การเปลี่ยนแปลงน้อยที่สุด
- การนำเข้าข้อมูลแบบเพิ่มอย่างเดียวผ่านทาง CDC
ชั้นที่ 2: ขัดเงา (สีเงิน)
- การทำความสะอาดข้อมูล
- การทำให้สคีมาเป็นมาตรฐาน
- ตรรกะการกำจัดข้อมูลซ้ำซ้อน
ชั้นที่ 3: คัดสรรพิเศษ (สีทอง)
- ชุดข้อมูลที่พร้อมใช้งานสำหรับธุรกิจ
- การรวมกลุ่มและการเชื่อมต่อ
- ปรับแต่งเพื่อประสิทธิภาพการสืบค้นข้อมูลที่ดีที่สุด
2.3 การออกแบบระบบจัดเก็บข้อมูลด้วย Apache Iceberg
ทำไมถึงชื่อไอซ์เบิร์ก?
- การเปลี่ยนแปลงโครงสร้างข้อมูลโดยไม่ต้องเขียนข้อมูลใหม่
- วิวัฒนาการของการแบ่งพาร์ติชัน (สำคัญต่อความสามารถในการขยายขนาดในระยะยาว)
- ธุรกรรม ACID บนดาต้าเลค
- การเดินทางข้ามเวลาเพื่อการตรวจสอบ
การตัดสินใจเกี่ยวกับการออกแบบโต๊ะ
-
กลยุทธ์การแบ่งพาร์ติชัน
- อ้างอิงจากรูปแบบการเข้าถึงข้อมูล (เช่น วันที่ ภูมิภาค)
- หลีกเลี่ยงการแบ่งพาร์ติชันมากเกินไป (รูปแบบที่ไม่พึงประสงค์ที่พบได้ทั่วไป)
-
การเพิ่มประสิทธิภาพขนาดไฟล์
- ขนาดไฟล์เป้าหมาย: 512MB–1GB
- หลีกเลี่ยงปัญหาไฟล์ขนาดเล็กโดยใช้กระบวนการบีบอัดข้อมูล
-
กลยุทธ์การบดอัด
- การบดอัดตามกำหนดเวลาผ่านระบบ Airflow
- รวมไฟล์ขนาดเล็ก → เพิ่มประสิทธิภาพการอ่าน
2.4 เลเยอร์การสืบค้นข้อมูล (Trino)
การออกแบบคลัสเตอร์
- ผู้ประสานงาน + โหนดผู้ปฏิบัติงานหลายโหนด
- เปิดใช้งานการปรับขนาดอัตโนมัติผ่าน Kubernetes
เทคนิคการเพิ่มประสิทธิภาพการค้นหาข้อมูล
- การผลักดันภาคแสดง
- การตัดแต่งพาร์ติชั่น
- การเข้าร่วมการออกอากาศสำหรับโต๊ะขนาดเล็ก
- การปรับแต่งตัวเพิ่มประสิทธิภาพตามต้นทุน
การจัดการการทำงานพร้อมกัน
- กลุ่มทรัพยากรที่กำหนดค่าไว้
- การจัดลำดับความสำคัญของคำค้นหา (BI เทียบกับแบบเฉพาะกิจ)
2.5 ชั้นการนำเข้าข้อมูล (CDC + NiFi)
ศูนย์ควบคุมและป้องกันโรค (CDC) ผ่านทางสตรีม
- การบันทึกการเปลี่ยนแปลงตามบันทึก
- ด้ามจับ:
- แทรก
- การอัปเดต
- ลบ
ความท้าทายด้านการออกแบบของ CDC
- เหตุการณ์ผิดปกติ
- เหตุการณ์ซ้ำซ้อน
- ข้อมูลที่มาถึงล่าช้า
โซลูชัน
- การเรียงลำดับตามเวลาของเหตุการณ์
- คีย์การลบข้อมูลซ้ำ
- กลยุทธ์การใส่ลายน้ำ
ท่อส่งข้อมูล NiFi
- ใช้สำหรับ:
- การนำเข้าแบบกลุ่ม
- แหล่งข้อมูลภายนอก
- การกำหนดค่าการจัดการแรงดันย้อนกลับ
2.6 การจัดการระบบ (Airflow)
หลักการออกแบบ DAG
- DAG แบบโมดูลาร์ (ต่อโดเมน)
- งานที่ไม่มีผลใดๆ
- นโยบายการลองใหม่ด้วยการหน่วงเวลาแบบเลขชี้กำลัง
การจัดการการพึ่งพา
- การพึ่งพาในระดับงาน
- การเรียกใช้งานตามชุดข้อมูล (ในกรณีที่สามารถทำได้)
3. การจัดเตรียมโครงสร้างพื้นฐาน
3.1 สถาปัตยกรรมของ Kubernetes
การตั้งค่าคลัสเตอร์
- คลัสเตอร์หลายโหนด
- กลุ่มโหนด:
- ใช้ทรัพยากรการประมวลผลสูง (เครื่อง Trino)
- ใช้พื้นที่จัดเก็บข้อมูลมาก (โหนดข้อมูล)
- ใช้งานทั่วไป (การไหลเวียนของอากาศ, NiFi)
การกำหนดค่าหลัก
- ระบบปรับขนาดพอดแนวนอนอัตโนมัติ (HPA)
- งบประมาณการหยุดชะงักของพอด
- กฎความสัมพันธ์ของโหนด
3.2 กลยุทธ์การใช้งาน
การปรับใช้แบบ Helm
- การกำหนดค่าพารามิเตอร์
- ค่าเฉพาะสภาพแวดล้อม
กลยุทธ์เนมสเปซ
- แยกเนมสเปซสำหรับ:
- การกลืนกิน
- กำลังประมวลผล
- การเรียบเรียงดนตรี
- การกำกับดูแล
3.3 โครงสร้างพื้นฐานด้านการจัดเก็บข้อมูล
- พื้นที่จัดเก็บข้อมูลแบบอ็อบเจ็กต์ (ใช้งานร่วมกับ S3 ได้)
- วอลุ่มถาวรสำหรับส่วนประกอบที่มีสถานะ
3.4 การสร้างเครือข่าย
- เครือข่ายบริการภายใน (ไม่บังคับ)
- การสื่อสารที่ปลอดภัยผ่าน TLS
- การควบคุมการเข้าถึงตามบทบาท (RBAC)
4. แนวทางการพัฒนา
4.1 กรอบงานไปป์ไลน์ (DigileEdge)
- ไปป์ไลน์ที่ขับเคลื่อนด้วยการกำหนดค่า (แบบ YAML/JSON)
- แม่แบบที่สามารถนำกลับมาใช้ใหม่ได้:
- การกลืนกินของ CDC
- การนำเข้าแบบกลุ่ม
- งานด้านการเปลี่ยนแปลง
4.2 การประมวลผลแบบไม่เปลี่ยนแปลงสถานะ
- แต่ละไปป์ไลน์ได้รับการออกแบบให้สามารถเรียกใช้งานซ้ำได้
- ไม่มีข้อมูลซ้ำซ้อนในการลองใหม่
4.3 การจัดการวิวัฒนาการของสคีมา
- วิวัฒนาการของแผนผังภูเขาน้ำแข็ง
- รองรับการใช้งานร่วมกับเวอร์ชันเก่า
4.4 การควบคุมเวอร์ชัน
- อิงตาม Git
- โค้ดและไฟล์การกำหนดค่ามีการกำหนดเวอร์ชันร่วมกัน
4.5 กรอบคุณภาพข้อมูล
- กฎการตรวจสอบความถูกต้อง:
- การตรวจสอบค่าว่าง
- การตรวจสอบช่วง
- ความสมบูรณ์ของการอ้างอิง
5. กลยุทธ์การดำเนินการ
5.1 แนวทางการย้ายถิ่นฐาน
- การย้ายข้อมูลแบบเพิ่มทีละตาราง (table-by-table)
- การทำงานแบบขนาน:
- ระบบเก่าเทียบกับระบบใหม่
5.2 กลยุทธ์การเปลี่ยนผ่าน
- การทดสอบโหมดเงา
- การเปลี่ยนผ่านทีละน้อย
5.3 กลยุทธ์การย้อนกลับ
- ชุดข้อมูลที่มีการกำหนดเวอร์ชัน
- ย้อนกลับไปยังสแนปช็อตก่อนหน้า
6. กลยุทธ์การทดสอบ
6.1 การตรวจสอบความถูกต้องของข้อมูล
- การกระทบยอดระดับแถว
- การตรวจสอบความถูกต้องโดยใช้แฮช
6.2 การทดสอบประสิทธิภาพ
- แบบสอบถามมาตรฐาน
- การทดสอบโหลดด้วยข้อมูลจำลองและข้อมูลจริง
6.3 การทดสอบความโกลาหล
- ความล้มเหลวของโหนด
- การหยุดชะงักของเครือข่าย
6.4 การทดสอบท่อส่ง
- การทดสอบหน่วยสำหรับการแปลงข้อมูล
- การทดสอบการบูรณาการข้าม DAG
6.5 การตรวจสอบ SLA
- ระยะเวลาดำเนินการของไปป์ไลน์ตั้งแต่ต้นจนจบ
- เกณฑ์การแจ้งเตือน
7. การตรวจสอบและการดำเนินงาน
สแต็กการตรวจสอบ
- ตัวชี้วัด:
- ซีพียู หน่วยความจำ
- ความล่าช้าในการสอบถาม
- บันทึก:
- การบันทึกข้อมูลแบบรวมศูนย์
- การแจ้งเตือน:
- การละเมิด SLA
- ความล้มเหลวของท่อส่ง
ความสามารถในการตรวจสอบข้อมูล
- การติดตามลำดับวงศ์ตระกูล (DataHub)
- ตัวชี้วัดความทันสมัยของข้อมูล
- แดชบอร์ดคุณภาพข้อมูล
8. ผลลัพธ์สุดท้าย
- การนำเข้าข้อมูลแบบเรียลไทม์: ระบบประมวลผลข้อมูลที่ขับเคลื่อนด้วย CDC ช่วยให้ได้ข้อมูลที่ทันสมัยเกือบจะในทันทีในทุกโดเมน.
- เลเยอร์การสืบค้นข้อมูลที่ปรับขนาดได้: Trino บน Kubernetes ปรับขนาดอัตโนมัติเพื่อรองรับปริมาณงาน BI และงานเฉพาะกิจที่เกิดขึ้นพร้อมกัน.
- โครงสร้างพื้นฐานที่ยืดหยุ่น: การปรับใช้แบบเนทีฟของ Kubernetes พร้อมการกู้คืนที่ผ่านการทดสอบความโกลาหลและการย้อนกลับแบบมีเวอร์ชัน.
- เวิร์กโฟลว์อัตโนมัติเต็มรูปแบบ: Airflow DAGs จัดการไปป์ไลน์แบบครบวงจร พร้อมระบบตรวจสอบการทำงานในตัว.
ข้อคิดส่งท้าย
นี่ไม่ใช่แค่การปรับปรุงให้ทันสมัยเท่านั้น แต่เป็นการเปลี่ยนแปลงจาก:
ข้อมูลในฐานะที่เก็บข้อมูล → ข้อมูลในฐานะแพลตฟอร์มแบบเรียลไทม์
ติดตามเราเพื่อรับข่าวสารล่าสุดได้ที่ ลิงก์อิน, ทวิตเตอร์, เฟซบุ๊ก, อินสตาแกรม, และ ยูทูบ.
